
¿Qué ve un crawler de inteligencia artificial cuando entra a una tienda chilena? Depende mucho más de lo que parece, y casi siempre depende de cómo esa tienda usa JavaScript.
Google, cuando visita una página, ejecuta el JavaScript y lee la versión terminada, aunque lo hace con demora y sin hacer clic en nada. Los crawlers de ChatGPT, Claude y Perplexity funcionan de otra forma: no ejecutan JavaScript, leen el HTML que entrega el servidor en la primera respuesta y con eso se quedan. Si el precio, la descripción o los enlaces a otras categorías aparecen recién cuando corre el JavaScript, para esos sistemas simplemente no están.
Queríamos saber cuánto de su contenido entrega el ecommerce chileno en ese primer HTML, así que en octubre de 2026 medimos 103 tiendas. En cada una comparamos la home, una categoría y una ficha de producto en tres versiones: lo que entrega el servidor, lo que queda después de ejecutar el JavaScript y lo que aparece al recorrer la página hasta el final.
La tienda típica entrega en el HTML el 80% de su contenido visible, lo que de entrada no está mal. El problema está en los extremos: una de cada cuatro tiendas entrega menos de la mitad, y en la plataforma más dependiente de JavaScript el precio no aparece en el texto que lee un crawler de IA en 13 de cada 14 fichas.
Cómo se hizo el estudio de renderizado en 103 ecommerce chilenos
Armamos la muestra en dos partes. La primera son 57 tiendas reconocidas del ecommerce chileno, de todos los rubros y plataformas. La segunda son 46 tiendas que aparecen al menos dos veces en el top 10 orgánico de Google Chile cuando se buscan productos, en 78 búsquedas de compra repartidas en 14 categorías: moda, calzado, tecnología, electro y hogar, ferretería, supermercado, farmacia y belleza, deporte, mascotas, infantil, libros y oficina, accesorios, automotriz y hobbies. Las dos partes llegaron a resultados casi idénticos, con una mediana de dependencia de JavaScript de 20,1% en la primera y de 22,6% en la segunda, así que la selección de tiendas conocidas no sesgó el resultado.
Dejamos fuera a las tiendas que bloquean el rastreo, a las que responden con una verificación antibot y a las que devuelven un error cuando se les pide el HTML sin un navegador. Cada URL la medimos respetando el robots.txt de la tienda y con un user-agent identificado. Al final quedaron 103 tiendas y 286 URL: 103 home, 94 categorías y 89 fichas de producto.
Cada URL pasó por tres mediciones:
- El HTML de la respuesta, que obtuvimos con un cliente HTTP que no ejecuta JavaScript. Es lo que lee un crawler de IA.
- El DOM renderizado, que armamos con Chromium a través de Playwright, esperando a que la red quedara inactiva y sin tocar nada. Es lo más parecido a lo que indexa Google.
- El DOM después de recorrer la página hasta el final con la rueda del mouse, para capturar el contenido que solo aparece con una interacción.
En cada una de esas versiones medimos las palabras visibles, sin contar scripts ni estilos, además del H1, el title, la canonical, la meta robots, el schema de producto, si el precio aparecía en el texto y cuánto pesaba el HTML. La plataforma de cada tienda la identificamos por las huellas que deja en su código.
La medida principal es el porcentaje de palabras visibles después del render que no estaban en el HTML de la respuesta. Esa diferencia también incluye banners, carruseles y widgets que no son contenido principal, así que los porcentajes hablan de dependencia de JavaScript y no de contenido perdido para SEO. Por eso los hallazgos sobre precio, schema, encabezados y tamaño los medimos aparte.
Resumen de hallazgos sobre renderizado de JavaScript en 103 ecommerce chilenos
| Hallazgo | Resultado |
|---|---|
| Mediana por tienda de contenido que aparece solo con JavaScript | 20,1% |
| Tiendas que entregan menos de la mitad de su contenido en el HTML | 24 de 103 |
| Tiendas con al menos una plantilla sin texto en el HTML | 8 de 103 |
| Plataforma más dependiente de JavaScript | VTEX Store Framework, 41,8% |
| Fichas con el precio en el texto visible del HTML | 57 de 83 |
| Fichas sobre VTEX Store Framework con el precio en el texto visible | 1 de 14 |
| Fichas con schema de producto en el HTML de la respuesta | 73 de 89 |
| URL que superan los 2 MB que procesa Googlebot | 36 de 286 |
| URL con texto visible después del corte de 2 MB | 9, en 8 tiendas |
| URL sin H1 ni siquiera después del render | 65 de 286 |
1. Una de cada cuatro tiendas online chilenas entrega menos de la mitad de su contenido en el HTML
En 24 de las 103 tiendas, más de la mitad del texto visible aparece recién después de ejecutar JavaScript, lo que en la práctica significa que para un crawler de IA esas tiendas existen a medias. Hay ocho casos más extremos todavía, con al menos una plantilla sin una sola palabra en el HTML: son aplicaciones que se construyen por completo en el navegador, y a un sistema que no ejecuta JavaScript lo único que le muestran es un contenedor vacío.
En el otro extremo hay 30 tiendas que dependen de JavaScript para menos del 10% de su contenido, y en ellas un crawler de IA lee prácticamente lo mismo que una persona. Las 49 restantes quedan en el medio, entre el 10% y el 50%.
Para una tienda, el primer paso es saber en qué grupo está, y eso se resuelve en minutos: abrir el código fuente de la home, de una categoría y de una ficha, y buscar si el nombre del producto, el precio y los enlaces a otras categorías están ahí. Si no están, la tienda está en el grupo que depende del JavaScript para algo que importa.
2. VTEX Store Framework y los frontends propios son las plataformas de ecommerce más dependientes de JavaScript
La plataforma pesa bastante en el resultado. En la tienda típica sobre VTEX Store Framework, el 41,8% del contenido visible aparece solo después de ejecutar JavaScript, mientras que en Shopify y en Salesforce Commerce Cloud, que renderizan sus plantillas en el servidor, esa cifra baja a cerca del 12%.
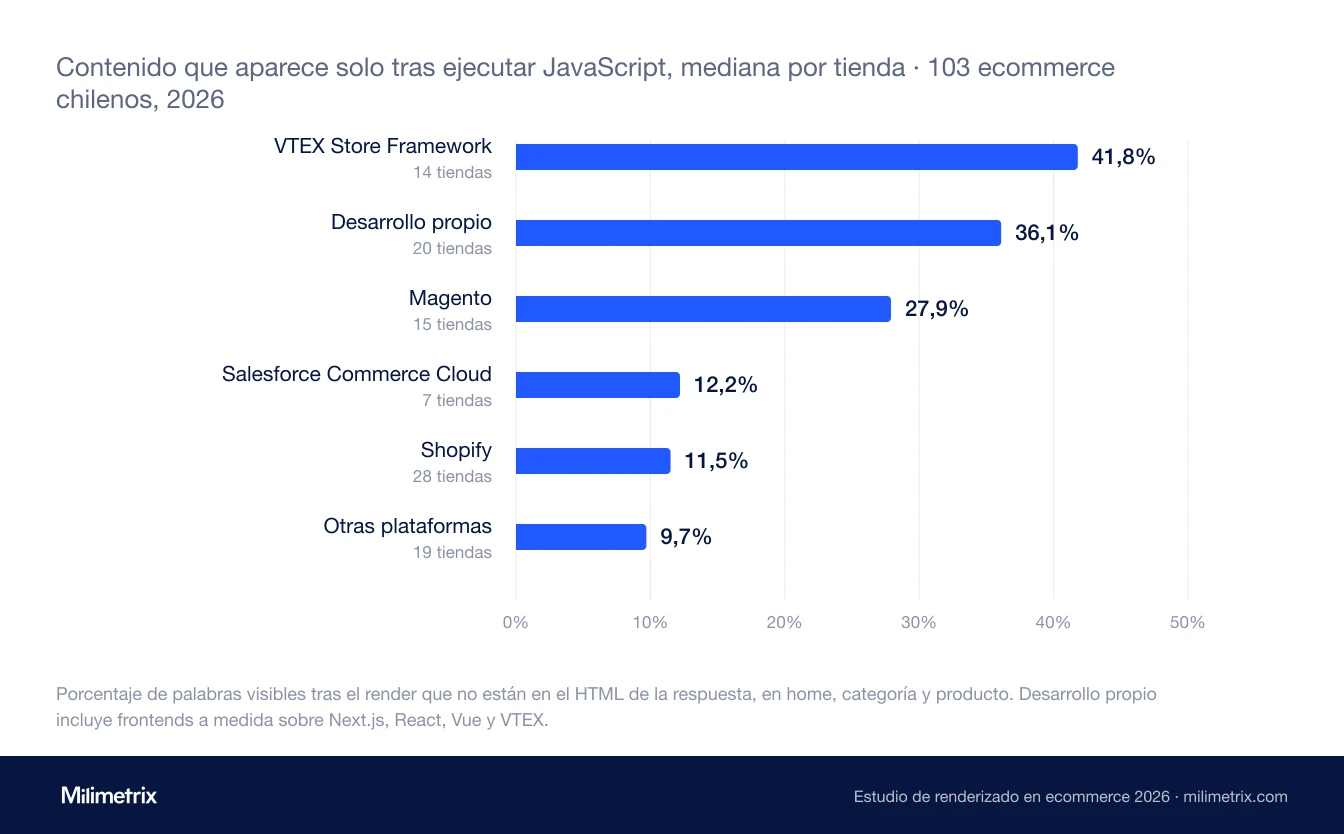
| Plataforma | Tiendas | Mediana por tienda | Tiendas con más del 50% |
|---|---|---|---|
| VTEX Store Framework | 14 | 41,8% | 6 |
| Desarrollo propio | 20 | 36,1% | 9 |
| Magento | 15 | 27,9% | 2 |
| Salesforce Commerce Cloud | 7 | 12,2% | 0 |
| Shopify | 28 | 11,5% | 2 |
| Otras plataformas | 19 | 9,7% | 5 |
Lo de VTEX Store Framework tiene una explicación bastante concreta: la plataforma renderiza en el cliente los componentes que están bajo el pliegue y trae opciones de rendimiento para diferir menús, resultados de búsqueda y filtros, que muchas tiendas activan sin medir el costo en SEO. Cuando auditamos una tienda sobre VTEX, lo primero que revisamos es qué opciones de rendimiento están activas y qué queda bajo el pliegue, porque ahí suelen estar los enlaces a categorías que Google no alcanza a descubrir. El resultado de Salesforce Commerce Cloud hay que leerlo con cuidado: son solo 7 tiendas, así que lo tomamos más como una señal que como una medición de la plataforma.
El grupo de desarrollo propio deja claro que la plataforma no lo decide todo. Ahí conviven grandes retailers con menos del 5% de dependencia y frontends a medida que entregan una home casi vacía. Usar Next.js, React o Vue no garantiza un buen resultado ni uno malo; lo que decide qué llega en el HTML es cómo está configurada cada ruta.
3. La ficha de producto es la plantilla de ecommerce que más depende de JavaScript
Si se separan los resultados por plantilla, la ficha de producto es la que más contenido deja fuera del HTML: su mediana es de 28,4%, contra un 16,0% en la home y un 11,8% en la categoría. Y es justo la página que tiene que posicionar en las búsquedas de producto, y la que un agente de compra necesita leer para comparar.
El patrón se repite en casi todas las plataformas. La descripción, las especificaciones, el selector de variantes y las reseñas se cargan después, desde el estado de la aplicación o desde llamadas a APIs, en vez de llegar con el HTML. Por eso, si hay que elegir una plantilla para empezar a corregir, casi siempre conviene que sea la ficha.
4. En 13 de 14 fichas sobre VTEX Store Framework el precio no está en el texto visible del HTML
El precio es el dato que más importa en una ficha y uno de los primeros que busca un sistema de IA para comparar productos. De las 83 fichas en las que pudimos detectarlo, 57 lo entregan en el texto visible del HTML de la respuesta. En otras 21 el precio sí está en el HTML, pero solo dentro de scripts, del estado de la aplicación o del JSON-LD, y en 5 no está de ninguna forma.
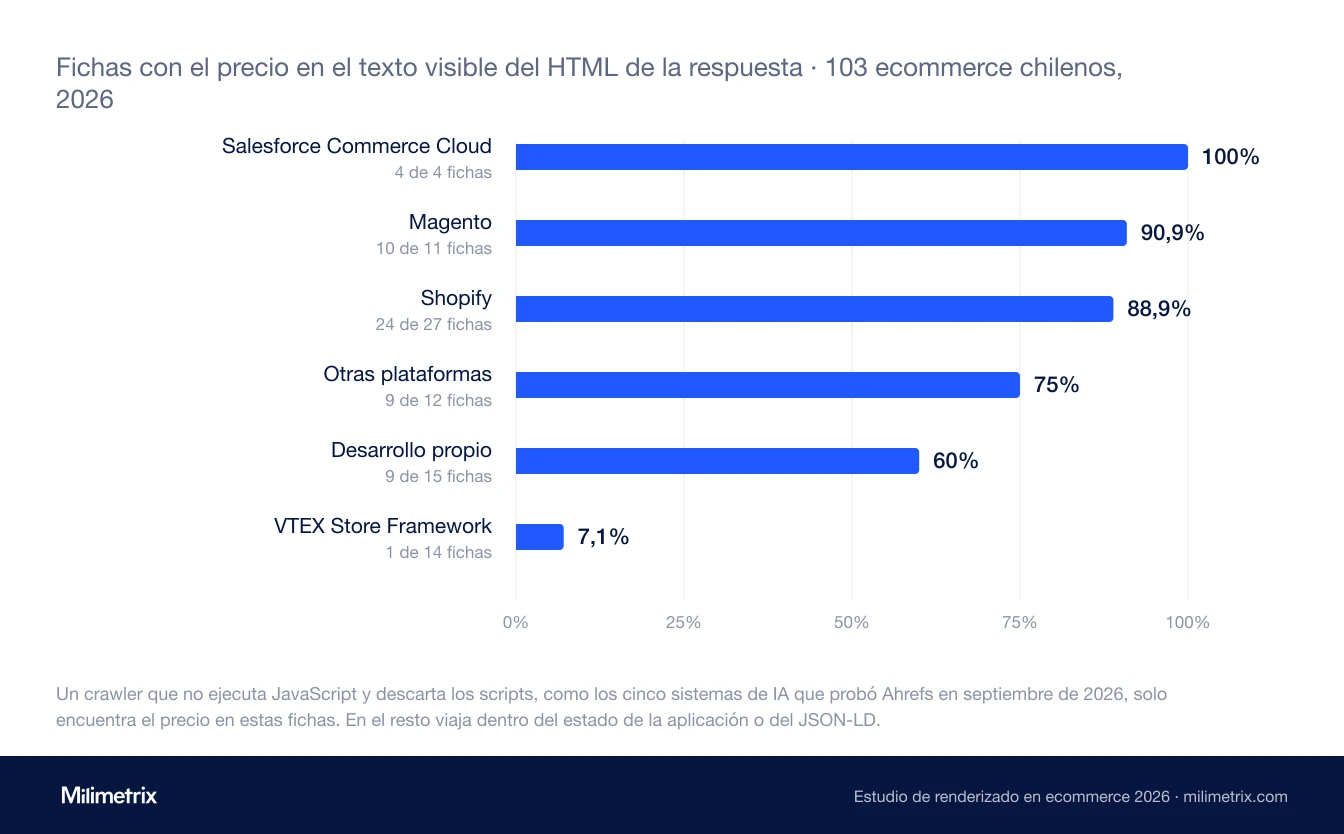
En VTEX Store Framework la diferencia es enorme: el precio aparece en el texto visible del HTML en 1 de 14 fichas. En las otras 13 viaja en el estado de la aplicación y en el JSON-LD, pero el texto llega sin él. En Shopify, en cambio, aparece en 24 de 27.
Uno podría pensar que, si el precio está en el JSON-LD, el problema está resuelto. No necesariamente. Una prueba de Ahrefs publicada en septiembre de 2026 encontró que cinco de los principales sistemas de IA ignoraron el JSON-LD, el Microdata oculto y el RDFa oculto de las páginas evaluadas, y sacaron la información solo del HTML visible. Con ese criterio, un crawler de IA lee la mayoría de las fichas sobre VTEX Store Framework de la muestra sin precio. Y cuando un modelo no encuentra el precio en la página oficial, lo busca en otra parte: en un comparador, en un marketplace o en un sitio de reseñas, y termina citando a ese tercero en lugar de la tienda. La corrección es simple de pedir: que el precio, además de estar en los datos estructurados, aparezca como texto en el HTML que entrega el servidor.
5. El schema de producto llega en el HTML en 73 de 89 fichas, mejor que el precio
Con el schema Product el panorama es bastante mejor. Está en el HTML de la respuesta en 73 de las 89 fichas, en 7 aparece solo después del render y 9 no lo tienen en ninguna versión. Para Google, que lee el schema renderizado, la situación es buena en la mayoría de las tiendas. Pero que el schema esté no resuelve lo anterior: en VTEX Store Framework casi todas las fichas tienen schema y casi ninguna tiene el precio como texto, que es lo que lee un crawler de IA. Y el schema que se inyecta con JavaScript, por ejemplo desde Google Tag Manager, llega a Google con la misma demora que el resto del render, algo que pesa en Shopping, donde precio y disponibilidad cambian seguido.
6. H1, title y canonical que solo aparecen después de ejecutar JavaScript
Los elementos que Google usa para entender e indexar una página también llegan tarde en una parte de la muestra. El H1 existe solo después del render en 24 URL de 17 tiendas, el title en 16 URL de 8 tiendas y la canonical en 29 URL de 13 tiendas.
Encontramos además dos casos que pueden pasar años sin que nadie los vea. En una tienda, la canonical del HTML es distinta de la que queda después del render, así que Google recibe dos señales para la misma página y termina eligiendo él cuál usar. En otra, una categoría recibe un noindex recién cuando se ejecuta el JavaScript. Las dos situaciones se detectan en minutos con un rastreo que compare el HTML original con el renderizado, y casi siempre vienen de una etiqueta publicada por Google Tag Manager o de un componente del tema.
Y hay un problema que ya no tiene que ver con el renderizado: 65 de las 286 URL, cerca de una de cada cuatro, no tienen H1 ni siquiera en la versión renderizada.
7. Una de cada ocho páginas de ecommerce supera los 2 MB que procesa Googlebot
Googlebot procesa solo los primeros 2 MB de cada archivo HTML, y lo que viene después no se renderiza ni se indexa. Para una página normal es un límite lejano, pero en la muestra 36 de las 286 URL lo superan.
En la mayoría de esas páginas, por suerte, el contenido visible está completo dentro de los primeros 2 MB, y lo que sobra es código: en la mediana de esas páginas, el 82% del archivo son scripts, sobre todo el estado de la aplicación incrustado como JSON. Pero en 9 URL de 8 tiendas una parte del texto visible queda después del corte. En el caso más extremo, el 67% de las palabras visibles de una categoría está más allá de los 2 MB, lo que significa que los productos del final del listado, y los enlaces hacia ellos, quedan fuera de lo que Google procesa. Se revisa mirando en DevTools el tamaño del documento principal sin comprimir, y en las categorías largas suele resolverse aligerando el estado JSON que la plataforma incrusta en la página.
8. En 33 tiendas hay contenido que solo aparece al hacer scroll y que Google no ve
Google no hace scroll ni hace clic, así que todo lo que aparece solo con una interacción se queda fuera de su índice. En 42 de las 286 URL, de 33 tiendas, recorrer la página hasta el final sumó más de un 5% de palabras al contenido visible. Casi siempre se trata de carruseles de productos relacionados, de reseñas o de bloques de la parte baja de la home que se cargan cuando el usuario llega a ellos.
Qué significa la dependencia de JavaScript para una tienda online
En la práctica, la misma tienda le llega a cada visitante en una versión distinta. Google indexa la versión renderizada, con demora y sin interacción. Los crawlers de IA leen el HTML de la respuesta y no ejecutan nada. Y los navegadores con agentes de IA ejecutan JavaScript como cualquier navegador, pero necesitan que la información esté en la página y que las acciones se puedan operar.
Para una tienda, la prioridad que sale de todo esto es bastante concreta: lo que vende, es decir, el precio, la descripción, las especificaciones y los enlaces a categorías y productos, tiene que estar en el HTML de la primera respuesta. El JavaScript puede seguir decidiendo cómo se muestra todo eso, pero no cuándo aparece.
Nos tocó verlo en un retail que armaba sus páginas del lado del cliente. Cuando le pedimos al equipo de desarrollo que el contenido viniera en el HTML inicial, la primera respuesta fue que el sitio iba a quedar más lento. Pero la discusión no era de velocidad: renderizar en el cliente solo traslada el trabajo al dispositivo de cada usuario, y lo que estaba en juego era si los rastreadores veían el contenido o no. Cuando el cambio se hizo, Google empezó a indexar productos y páginas nuevas que antes no alcanzaba a ver, mejoró la rastreabilidad y el sitio empezó a posicionarse mejor.
Para quien quiera entender el tema a fondo, Cristóbal Cazor, nuestro SEO Team Lead, escribió una guía de renderizado de JavaScript y SEO que explica paso a paso cómo renderiza Google, la diferencia entre el contenido oculto y el que depende de una interacción, y el método de auditoría con cada herramienta.
Cómo revisar en diez minutos si una tienda online depende de JavaScript
- Abrir "Ver código fuente" en una ficha de producto y buscar el precio, el nombre del producto y la descripción. Si no están ahí, un crawler de IA no los ve.
- Desactivar JavaScript en Chrome desde DevTools y recargar la home, una categoría y una ficha. Todo lo que desaparece depende de JavaScript.
- Revisar la Inspección de URL de Search Console en una ficha, mirando el HTML renderizado, la captura y los recursos que no cargaron.
- Rastrear el sitio dos veces en Screaming Frog, una en modo solo texto y otra con JavaScript, y comparar palabras, H1, title y canonical.
- Medir el peso del HTML de las categorías más largas. Si pasa de 2 MB, revisar si el contenido o los enlaces del final quedan después del corte.
- Bajar hasta el final de cada plantilla y anotar qué aparece recién ahí: reseñas, productos relacionados, filtros o más productos.
Preguntas frecuentes sobre el renderizado de JavaScript en ecommerce
¿Qué plataforma de ecommerce depende menos de JavaScript?
En nuestra muestra de 103 tiendas chilenas, Shopify y Salesforce Commerce Cloud son las que entregan más contenido en el HTML de la respuesta, con una mediana cercana al 12% de contenido que depende de JavaScript. VTEX Store Framework es la más dependiente, con 41,8%. Aun así, la configuración de cada tienda pesa tanto como la plataforma.
¿Google indexa el contenido que carga una tienda con JavaScript?
Sí, siempre que el contenido esté en la página cuando termina de cargar. Google renderiza todas las páginas que responden 200, aunque con demora. Lo que no indexa es lo que aparece solo después de un clic o de un scroll, ni lo que queda más allá de los primeros 2 MB del archivo.
¿Los crawlers de IA ven el precio de una ficha de producto?
Solo si el precio está como texto visible en el HTML de la respuesta. Los crawlers de OpenAI, Anthropic y Perplexity no ejecutan JavaScript, y varios sistemas de IA ignoran el JSON-LD al leer una página. En nuestra muestra, 26 de 83 fichas no entregan el precio como texto visible.
¿Cómo se sabe si una tienda depende de JavaScript?
La forma más rápida es comparar el código fuente de una página con lo que se ve en el navegador, o desactivar JavaScript y recargar. Para revisar una tienda completa, un rastreo con y sin renderizado en Screaming Frog o Sitebulb mide la diferencia plantilla por plantilla.
¿Cambiar de plataforma resuelve la dependencia de JavaScript?
No necesariamente. La plataforma marca una tendencia, pero dentro de cada grupo del estudio encontramos tiendas que entregan casi todo en el HTML y otras que no entregan casi nada. Antes de una migración, lo recomendable es medir la tienda actual y la configuración de la nueva, ruta por ruta.
Por qué la dependencia de JavaScript pasa años sin que nadie la vea
La razón es bastante simple: la dependencia de JavaScript no se ve en el navegador. Quien revisa la tienda la ve completa, porque su navegador ejecuta todo y porque esa persona sí hace clic y sí baja hasta el final. El problema aparece en los sistemas que no hacen ninguna de esas cosas, y esos sistemas son cada vez más: Google, con su demora y sin interacción, y los crawlers de IA, que leen solo la primera respuesta.
En Milimetrix auditamos el renderizado de una tienda plantilla por plantilla y lo corregimos junto al equipo de desarrollo, como parte de nuestro trabajo de SEO para ecommerce y de visibilidad en buscadores de IA.